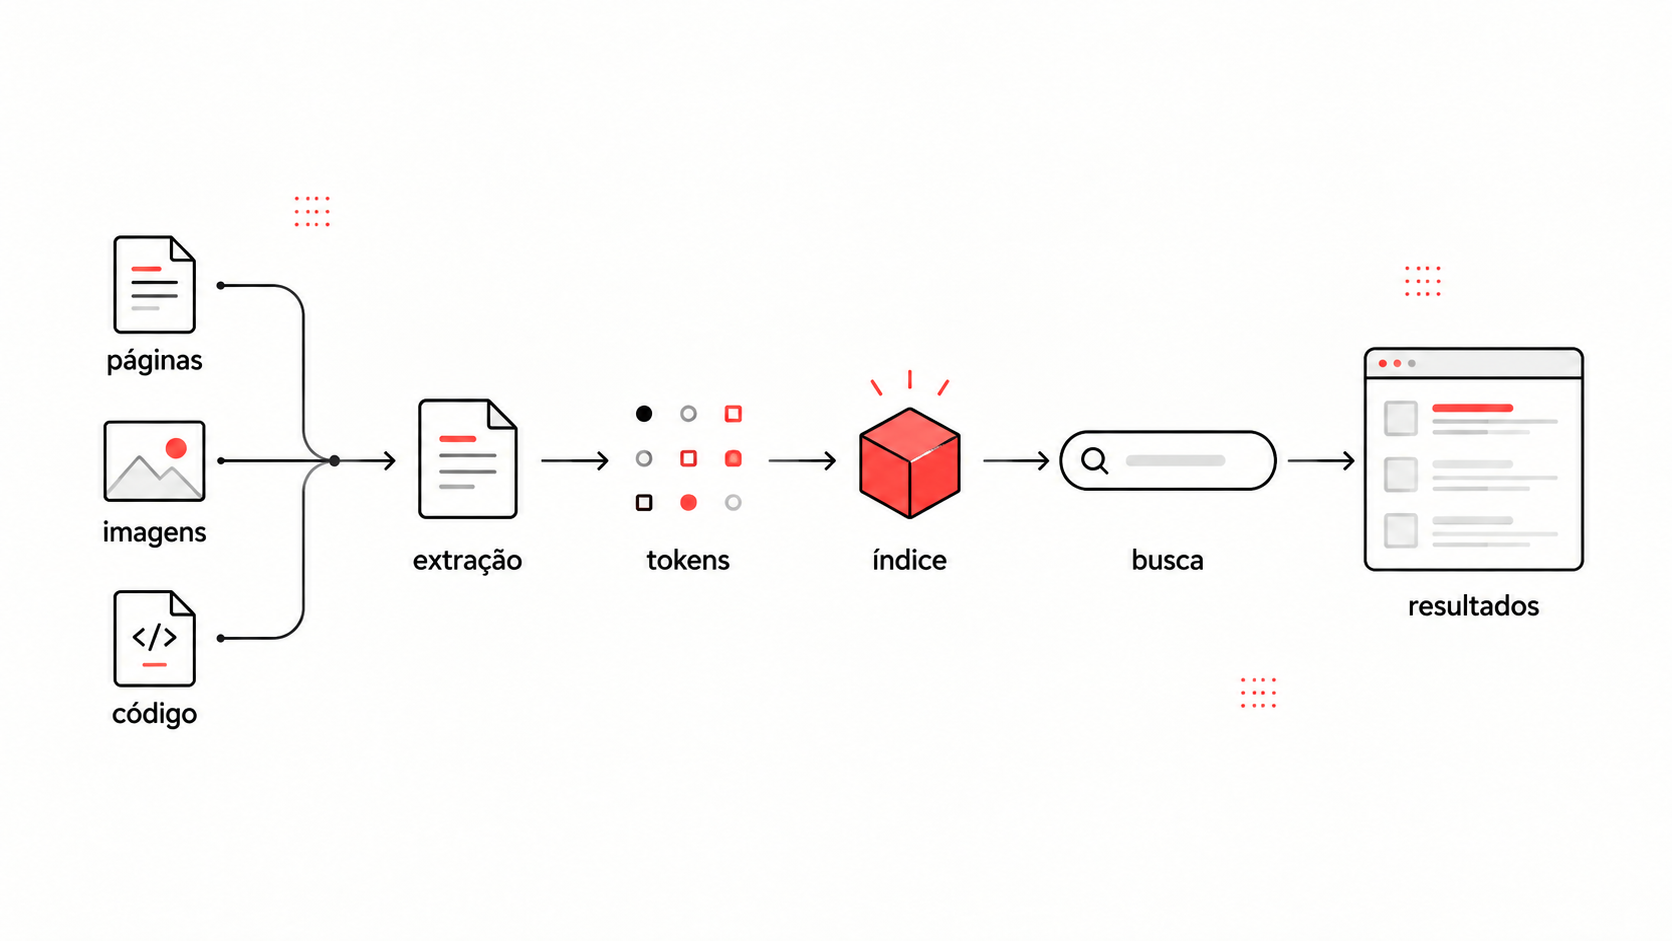
Busca client-side é uma boa combinação para sites Astro estáticos: as páginas continuam sendo HTML publicado e o navegador adiciona uma camada de descoberta quando o usuário precisa encontrar algo. O desafio é decidir onde cada parte do trabalho deve acontecer.
A arquitetura em duas fases
O modelo mais conhecido transforma o conteúdo em um corpus durante o build. Um endpoint estático reúne títulos, headings e texto das páginas e publica um JSON. No primeiro uso, o navegador carrega esse arquivo e constrói um índice em memória.
Essa separação mantém o deploy simples e evita um serviço externo de busca. O preço é que o primeiro uso concentra download, parsing e indexação no dispositivo do visitante.
Pagefind e MiniSearch resolvem problemas diferentes
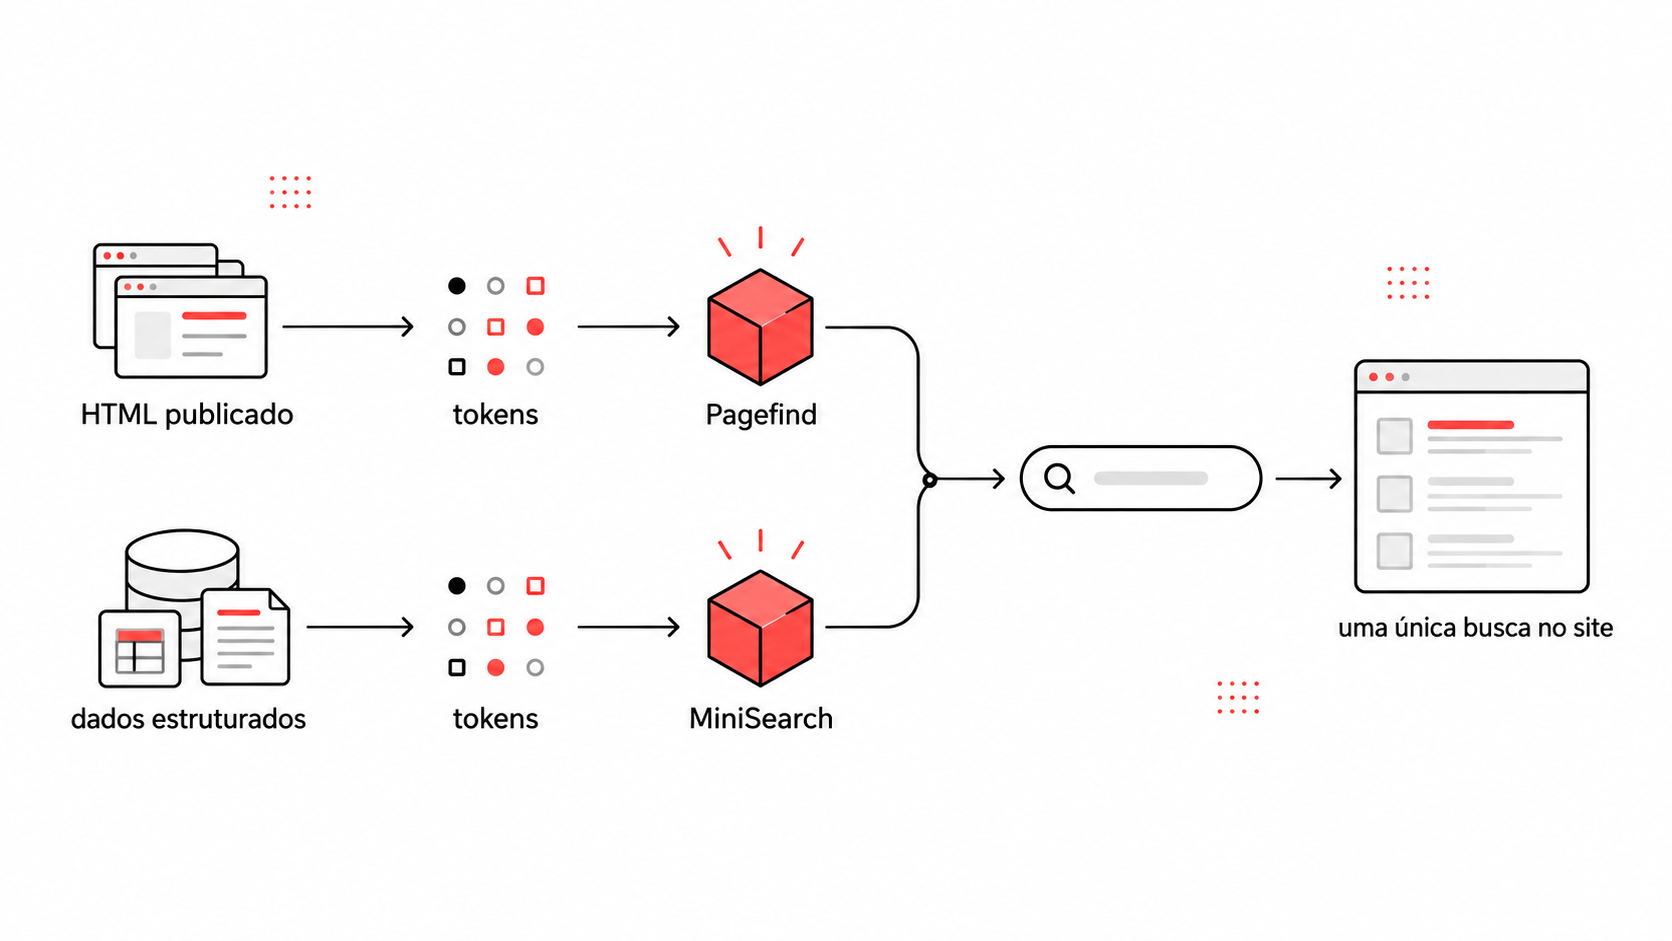
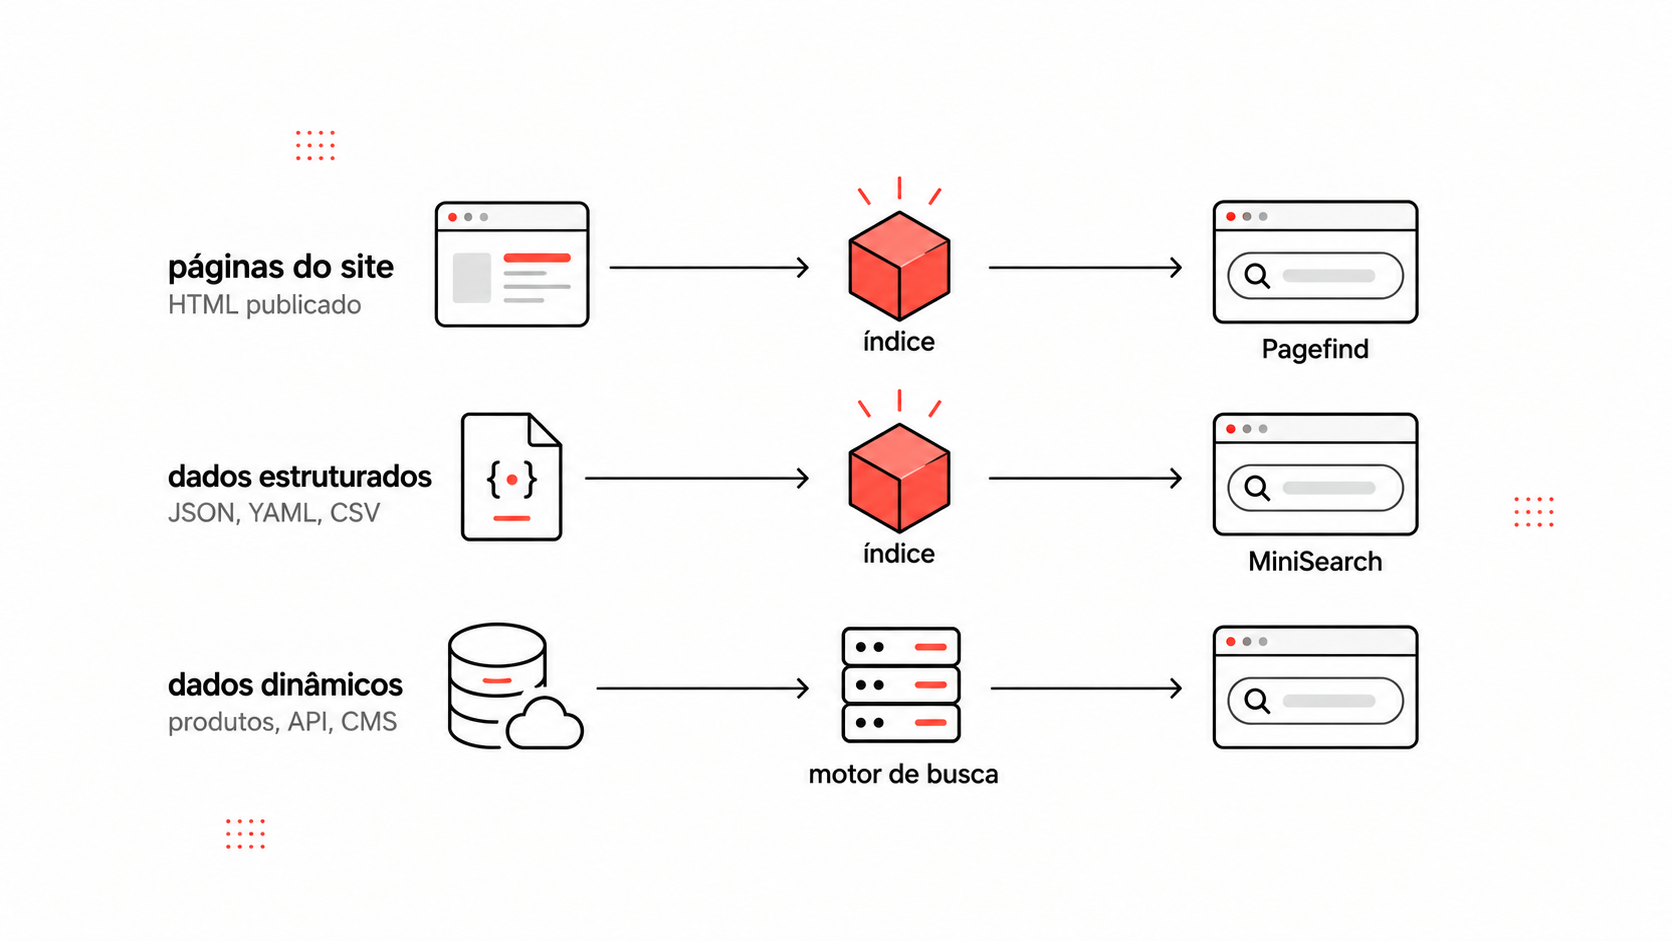
Pagefind trabalha sobre o HTML final depois do build. Isso aproxima o índice daquilo que realmente foi publicado e permite dividir os arquivos em partes menores, carregadas conforme a consulta precisa.
MiniSearch oferece mais controle programático sobre campos, ranking, prefixos, fuzzy search e pesos. Também pode receber documentos que não correspondem exatamente a páginas HTML. Em troca, exige que a aplicação cuide da geração e do carregamento do índice.
O custo pode sair do navegador
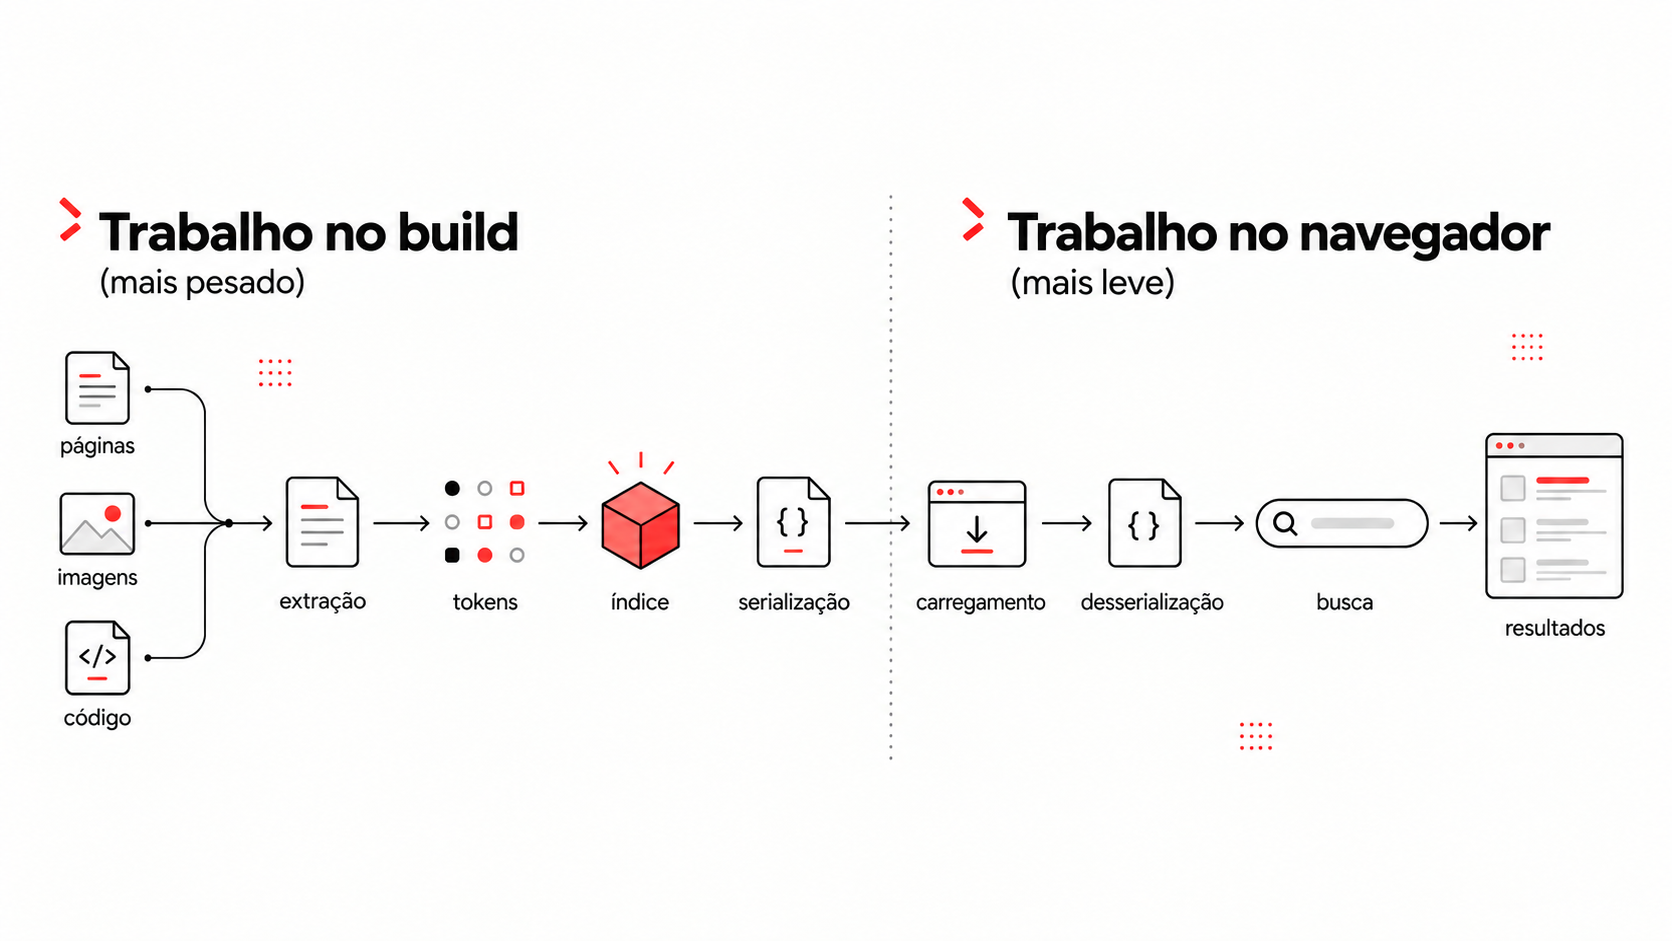
Na implementação original com MiniSearch, o build prepara o corpus e o browser executa `addAll()` para criar o índice. Uma evolução é serializar o índice já pronto durante o build e usar `loadJSONAsync()` no cliente.
Isso reduz CPU e long tasks no primeiro uso. Ainda existe o custo de baixar e desserializar o índice, por isso o tamanho do corpus, o tipo de aparelho e a frequência de uso continuam importantes.
A escolha depende da fonte pesquisável
Não existe uma engine universalmente melhor. Se a fonte é o HTML estático publicado, Pagefind costuma ser a opção mais equilibrada. Ele indexa a representação real da página e carrega chunks progressivamente.
Se a busca precisa combinar dados estruturados, documentos arbitrários ou uma lógica de ranking controlada pelo código, MiniSearch continua uma boa escolha. Para dados dinâmicos, facetas avançadas e grandes catálogos, um motor remoto como Meilisearch ou Typesense passa a fazer mais sentido — com dependência de rede e outras responsabilidades.
O que medir
O usuário não experimenta apenas o tempo de `search()`. A percepção inclui o download da engine, o índice, a descompressão, o parsing, a desserialização e a atualização visual dos resultados.
Vale medir cold cache e warm cache em desktop e mobile, bytes transferidos, tempo até a busca estar pronta, long tasks, heap máximo e qualidade do ranking. Uma consulta rápida que entrega resultados irrelevantes não resolve o problema.
Em qualquer solução local, o índice deve ser tratado como conteúdo público. Rascunhos, páginas privadas e informações sob embargo precisam ser excluídos antes do build. No browser, o destaque dos termos também deve renderizar texto com segurança, sem concatenar HTML não confiável.
Nossa recomendação
Para um site Astro de conteúdo, começaríamos com Pagefind. Ele combina bem com a saída estática, indexa o HTML final e evita manter um corpus monolítico no cliente.
MiniSearch é a alternativa quando o produto precisa de controle direto sobre o modelo de dados e o ranking. Nesse caso, preferimos construir e serializar o índice no build, carregando-o de forma assíncrona no primeiro uso.
A decisão não é apenas técnica. Ela envolve privacidade, custo de operação, tamanho do site, tipo de conteúdo e o que o usuário espera encontrar. O melhor mecanismo é aquele que torna a busca útil sem criar uma nova fonte de complexidade.