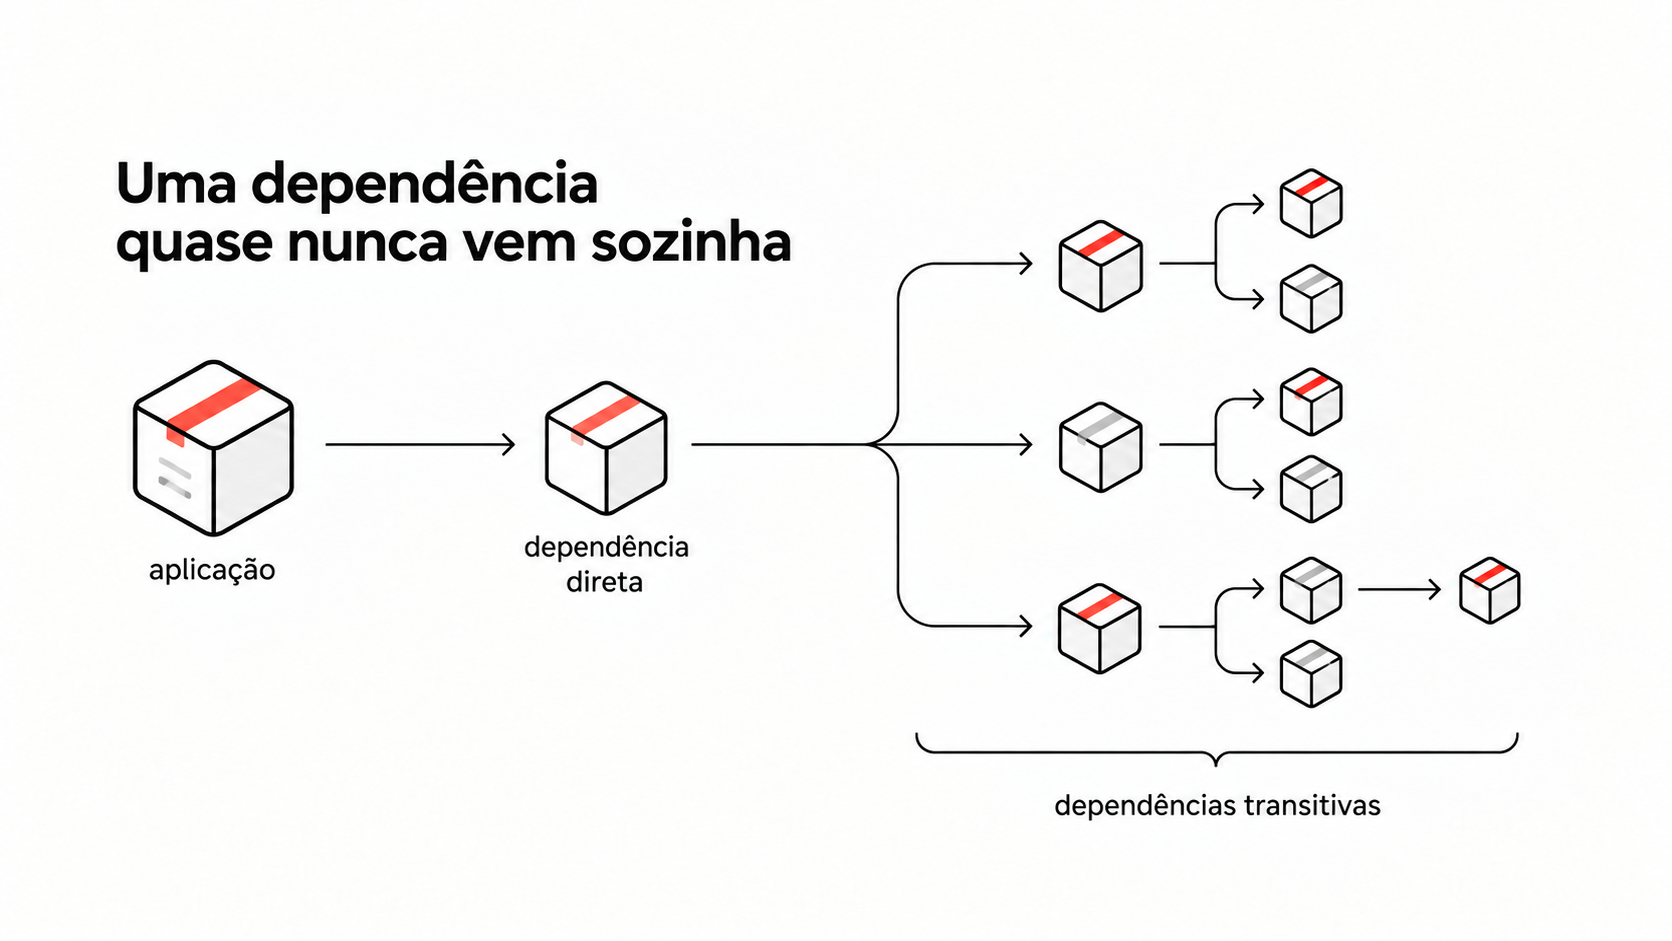
Adicionar uma dependência costuma parecer uma decisão pequena. O comando é curto, o pacote já existe e a documentação mostra como começar. Mas o que entra no projeto não é apenas uma biblioteca: é uma cadeia de componentes, licenças e responsabilidades.
A árvore é maior do que parece
Quando uma aplicação instala uma dependência direta, ela normalmente também instala outras dependências transitivas. Essas relações podem se multiplicar rapidamente e nem sempre ficam visíveis para quem adicionou o pacote original.
Isso importa porque cada componente pode ter origem, versão, licença e histórico próprios. Uma atualização aparentemente simples pode alterar essa árvore e introduzir uma obrigação que não existia antes.
Por isso, olhar apenas para o manifest principal do projeto não basta.
A licença é só uma parte da decisão
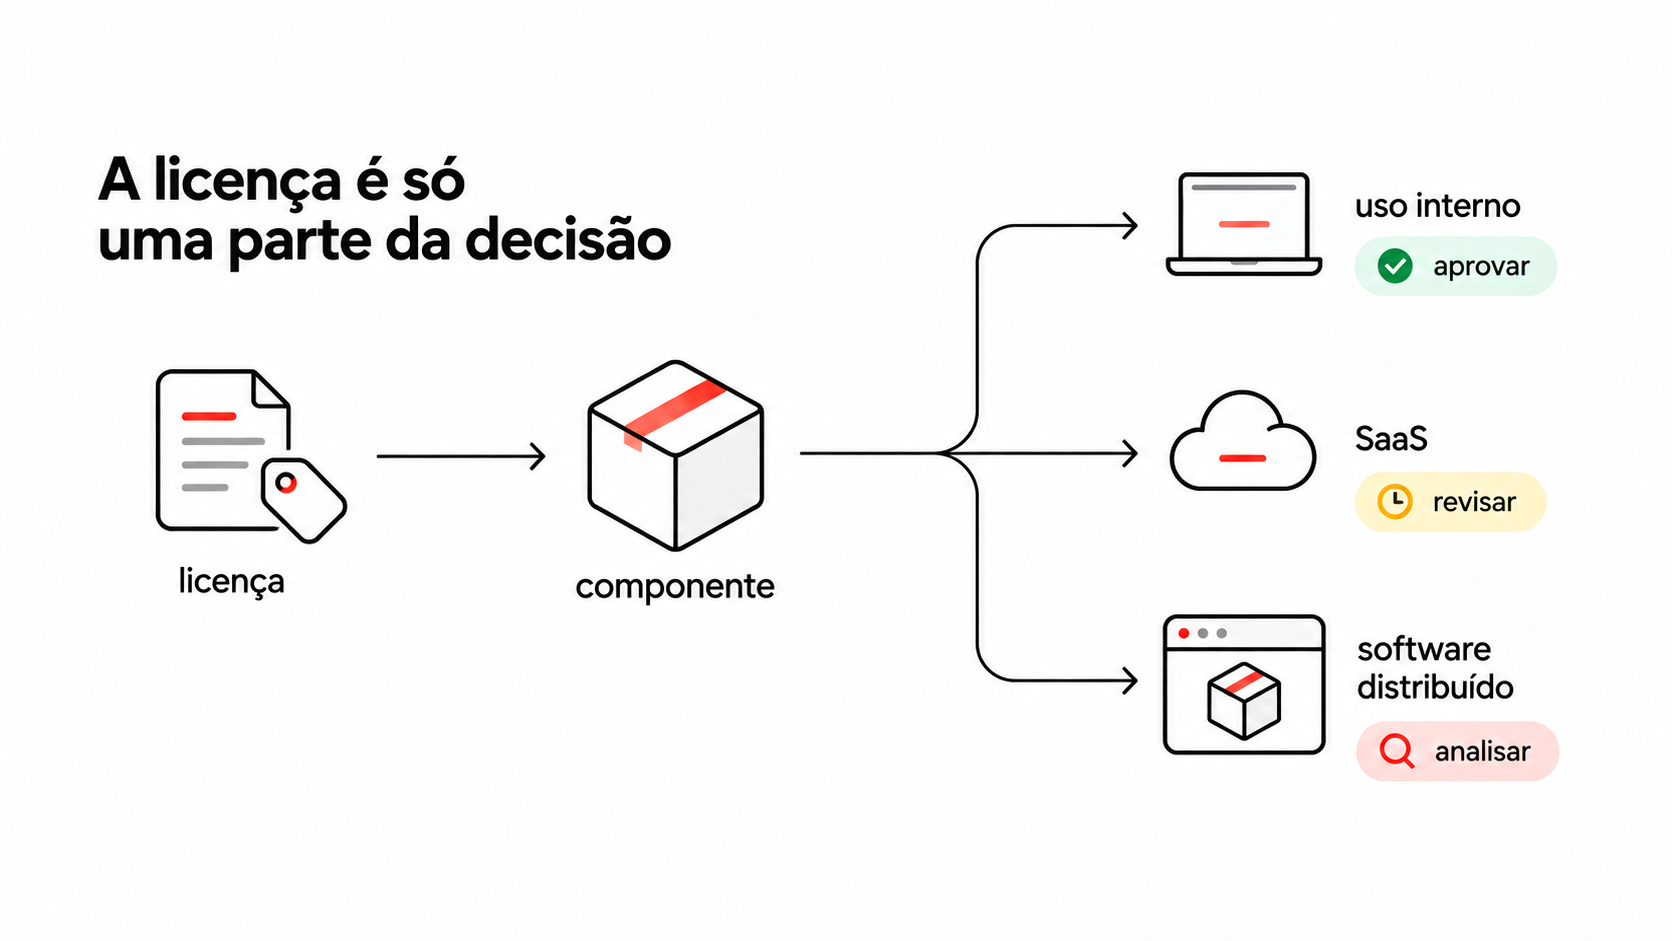
Licenças open source não são todas iguais. Algumas permitem uso, alteração e distribuição com poucas condições. Outras exigem avisos, preservação de termos, disponibilização de modificações ou cuidados específicos quando o software é distribuído.
A pergunta não é simplesmente se uma licença é “boa” ou “ruim”. É como aquele componente será usado: internamente, em um SaaS ou dentro de um software distribuído para terceiros.
Isso é mais útil do que classificar licenças como boas ou ruins.
Como isso pode funcionar sem virar burocracia
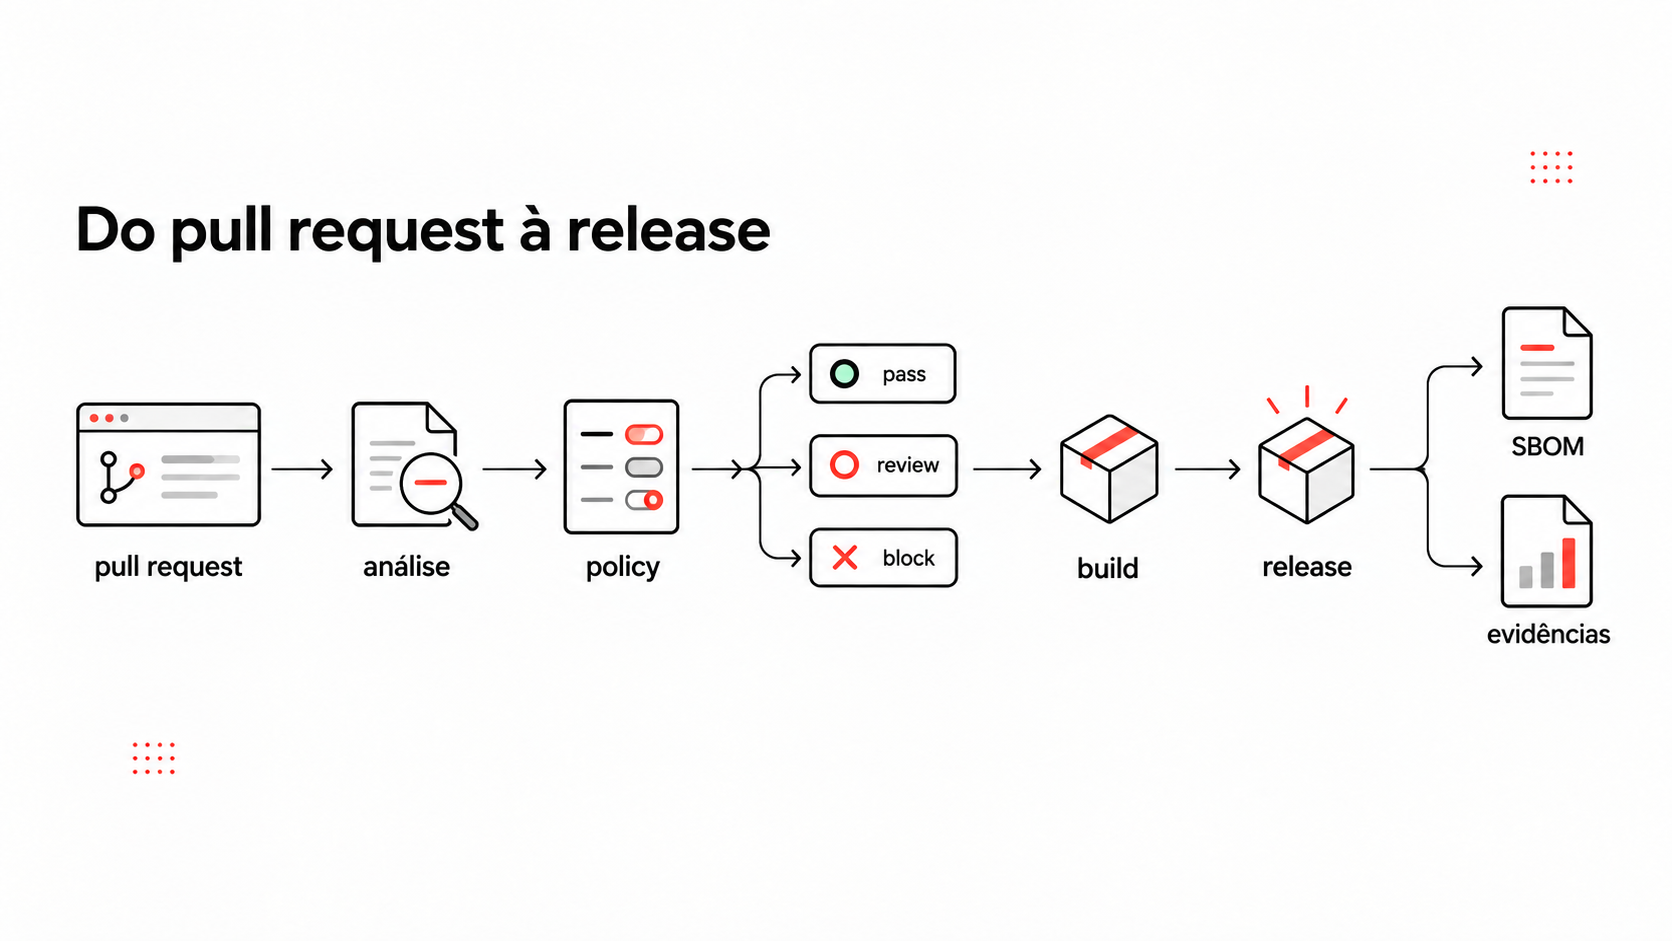
O objetivo não é transformar cada pull request em uma revisão jurídica manual. É criar um caminho proporcional ao risco. A análise pode identificar componentes, comparar licenças com uma política definida, sinalizar exceções e registrar a decisão.
Quando a situação é clara, o fluxo segue. Quando existe dúvida, alguém revisa. Quando há incompatibilidade, a equipe decide se troca o componente, ajusta o uso ou aceita formalmente o risco.
Quando a análise entra no pipeline, a decisão deixa de depender de memória e passa a gerar rastreabilidade na release.
Começar simples é melhor do que não começar
Uma política inicial não precisa resolver todos os casos possíveis. Pode começar com um inventário das dependências, uma lista curta de licenças permitidas e um processo para exceções.
O mais importante é tornar a decisão visível antes que o software seja distribuído. Depois, o processo pode ganhar automação, SBOM, regras mais específicas e evidências que ajudem em auditorias ou mudanças de equipe.
Esse cuidado aproxima engenharia, produto, segurança e jurídico. Não para criar uma camada a mais, mas para que uma escolha técnica continue fazendo sentido quando o software chegar ao mundo real.
O que vale colocar em prática
- Conhecer as dependências diretas e transitivas do produto.
- Registrar licença, versão e origem dos componentes relevantes.
- Definir uma política simples para os usos mais comuns.
- Automatizar a identificação no pipeline de entrega.
- Tratar exceções como decisões explícitas, não como problemas escondidos.
O comando `npm install` pode continuar sendo simples. A decisão sobre o que ele coloca dentro do produto é que merece contexto.
Referências
Open Source Initiative. Definição e licenças open source.
SPDX. Padrão para identificação e troca de informações sobre licenças.
OWASP. Software Component Verification Standard.